[论文笔记]Patch-to-PoC: A Systematic Study of Agentic LLM Systems for Linux Kernel N-Day Reproduction
Title: Patch-to-PoC: A Systematic Study of Agentic LLM Systems for Linux Kernel
N-Day Reproduction
Authors: Juefei Pu, Xingyu Li, Zhengchuan Liang, Jonathan Cox, Yifan Wu, Kareem Shehada, Arrdya Srivastav, Zhiyun Qian
Affiliations: University of California, Riverside
Challenges and Motivation
N-Day 漏洞的“窗口期”来自内核生态的补丁传播延迟。上游主线修复后,补丁需要逐级向下游 stable/LTS 分支和发行版内核移植,这一过程往往耗时数十天,部分补丁甚至因遗漏而滞留超过半年。在此背景下,攻击者可以在补丁已公开但下游尚未修复的间隙分析漏洞、开发利用。因此自动化 PoC 生成因此具有双重意义:一是攻击方降低利用门槛,同时还促使防守方加速漏洞分诊与补丁优先级判断。
但内核 PoC 生成远比用户态困难:内核极其庞大、接口异构(ioctl、netlink 等格式差异巨大)、高度有状态且多线程,多数漏洞需要多个系统调用甚至竞态条件才能触发,因此该工作研究的出发点为检验当前 LLM 智能体是否已经跨过这个门槛。
K-Repro 系统设计
本文构建了 K-Repro —— 一个以安全补丁 commit ID 为唯一外部输入的端到端智能体系统,其工作流程为给定补丁 commit 后让系统提取补丁内容,接着用确定性、非 LLM 流水线准备复现环境(补丁前一个 commit 的内核源码与可运行镜像)然后使用LLM 智能体在工具集辅助下迭代分析、构造 PoC、验证崩溃,最后输出 PoC、分析报告与日志。
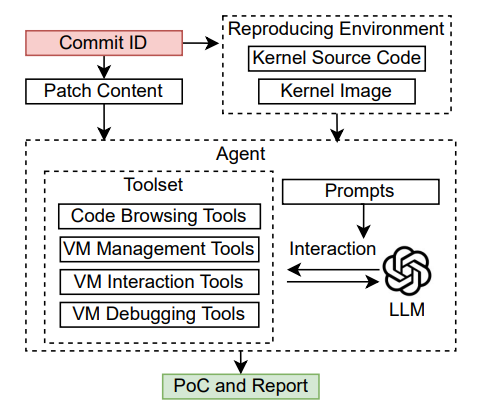
核心能力模块:
- 代码浏览:定位补丁涉及的数据流与触发路径
- 虚拟机管理:在 QEMU/KVM 环境中运行和调试内核
- 交互:通过命令行工具与内核子系统交互
- 调试:使用 GDB 设置断点、检查变量状态
在系统设计中存在一个关键选择:环境准备交付给确定流水线,而 LLM 仅负责理解补丁和构造触发这个认知密集型环节,保证了实验的可复现性,同时清晰地划定了 LLM 的贡献边界。
Experiment Design and Reustlt
数据集:来源于 Google KernelCTF 的 100 个真实可利用 Linux 内核漏洞
模型:GPT-5.1 Codex(Medium 推理级别)与 GPT-5.1 Codex Max(XHigh 推理级别)。
整体成功率:K-Repro 在 XHigh 配置下成功复现 56/100(56%),Medium 配置下 47/100(47%),均以“生成的 PoC 触发内核崩溃”为成功标准。
与 SyzDirect 的对比(在可构建环境的 85 个案例上):
Table 9 summarizes the comparison results. On the 85-case
aligned dataset, the LLM-centric approach, as instantiated by
K-REPRO (XHigh), successfully reproduces 57 vulnerabilities, corresponding to a success rate of 67.1%. In contrast, the
fuzzing-centric approach represented by SyzDirect reports
42 successful reproductions out of 100 cases in its original
evaluation.
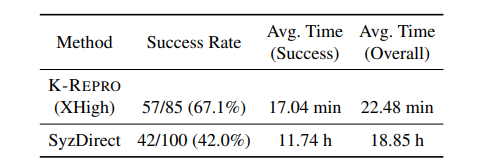
结论:K-Repro 的成功率显著高于 SyzDirect,且耗时从小时级压缩到分钟级。
Key Findings
4.1 复现并非仅单次尝试
智能体几乎不依赖单次尝试成功,而是通过多轮迭代逐步精炼 PoC。如观察GDB 的使用模式中,XHigh 在 62/100 案例中设置断点,其中 59 次断点被成功命中;即使在失败的 29 个 XHigh 案例中,断点也全部命中过。这说明可达性通常不是瓶颈,智能体能够到达目标代码区域,失败更多发生在触发条件构造与状态控制环节。
GDB 的使用方式以变量检查为主(XHigh 平均 5.4 次/案例),指令级 stepping 几乎不用(全程仅 3 次)。智能体偏好在关键点观察状态,而非逐指令跟踪。
子系统与漏洞类型的影响
按内核子系统分组,成功率差异在统计上不显著,其中 net、netfilter、bpf 的 p 值均较高,表现出 K-Repro 具有一定的泛化能力,没有严重偏科某一子系统;但竞态条件漏洞是明显短板,其中 Medium 在竞态类漏洞上成功率仅 5/24(20.8%),远低于整体水平。这符合直觉——竞态触发需要精确的时序控制,而当前智能体的交互模式(命令行调用 + GDB 断点)对多线程时序的操控能力有限。
工具与提示词的影响:成功率稳定,但执行路径改变
论文做了两组消融,结果值得关注:
提示词降级
当提示词中去掉了有关鼓励“形成假设并验证”等内容后,整体成功率下降不显著(XHigh 从 56% 降至 50%,p=0.17),但 GDB 使用模式剧烈变化,其中成功案例中 GDB 断点使用从 33 次骤降到 5 次,失败案例中反而仍有 16 次,体现出提示词变化让模型对于调试的态度从假设验证转为被动应对。
移除子系统命令行工具(nft、tc)
成功率变化同样不显著(XHigh 从 56% 降至 46%,p=0.20),但 PoC 的形态完全改变。原本成功 PoC 大量依赖 nft/tc(XHigh: 31/56),但工具移除后几乎消失(2/46),智能体转而直接在 C 代码中构造 netlink/netfilter 消息、调用系统调用。文献中的一个典型案例展示了这种适应能力:智能体最初 netlink 消息构造错误,转而用 nft 绕过;nft 不可用后,它回头阅读 nfnetlink_rcv_batch 源码,修正了 C 实现并成功触发。
这两组消融的共同启示:LLM 智能体的“成功率”对工具和提示词有一定鲁棒性,但成功路径的可解释性和效率会显著变化。工具和提示词的作用更多是引导智能体走更理性的分析路线,而非直接决定能否成功。
个人理解与启示
对自主安全智能体设计:K-Repro 的架构选择——确定性环境准备 + LLM 聚焦认知任务——是一个值得借鉴的范式。它把不可靠的环节(环境构建)与 LLM 的不确定性解耦,使得实验结果可归因。同时提示词消融的结果说明,鼓励假设-验证循环的提示设计是让智能体行为更像安全研究员的关键,即便它不直接提升成功率,也改变了调试的行为。
对 N-day 攻防评估:50%+ 的复现率在分钟级、数美元成本下实现,意味着补丁公开后的自动化利用开发门槛正在实质性下降。但竞态漏洞的低成功率(20.8%)提供了一个暂时的缓冲带,防守方至少可以在竞态类漏洞上争取更多窗口。不过这个缓冲带能维持多久,取决于后续工作能否在时序控制上取得突破。
局限与开放问题:论文的成功标准是触发崩溃,而非实现可控利用,在真实场景下从崩溃到实际可利用(控制流劫持、提权)之间仍有距离。此外,模型知识截止日期对结果的影响论文有讨论(4.5 节),但未改变整体结论。竞态漏洞的瓶颈是否源于工具集限制(缺乏精确时序操控手段)还是 LLM 本身的多线程推理能力,值得进一步拆解。